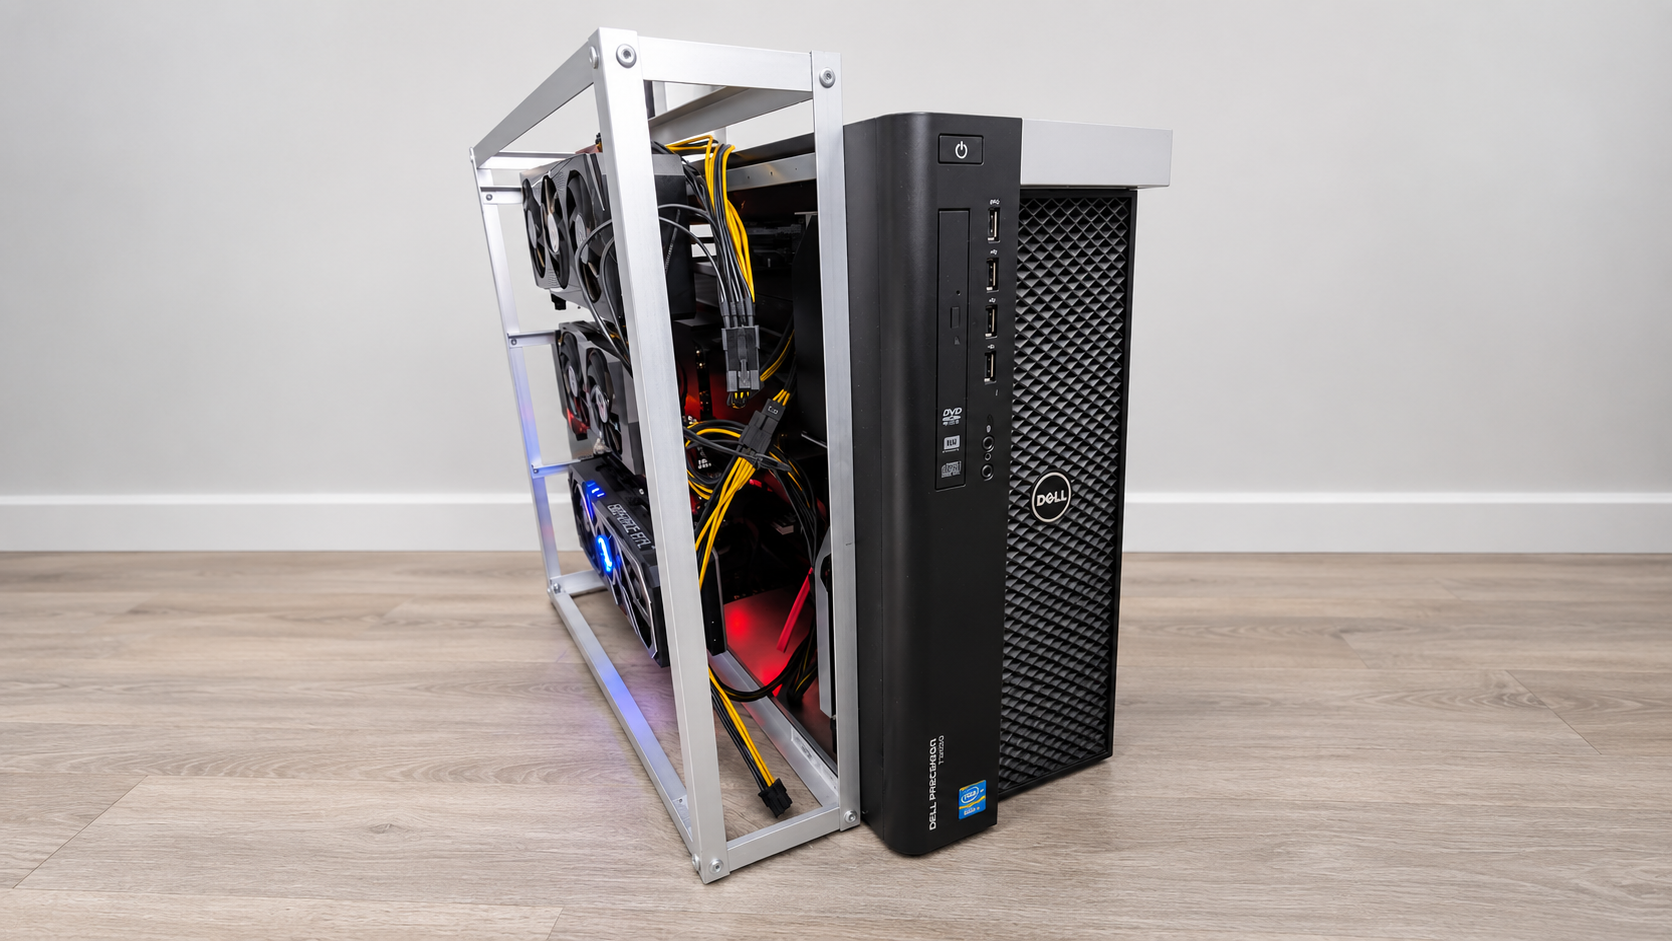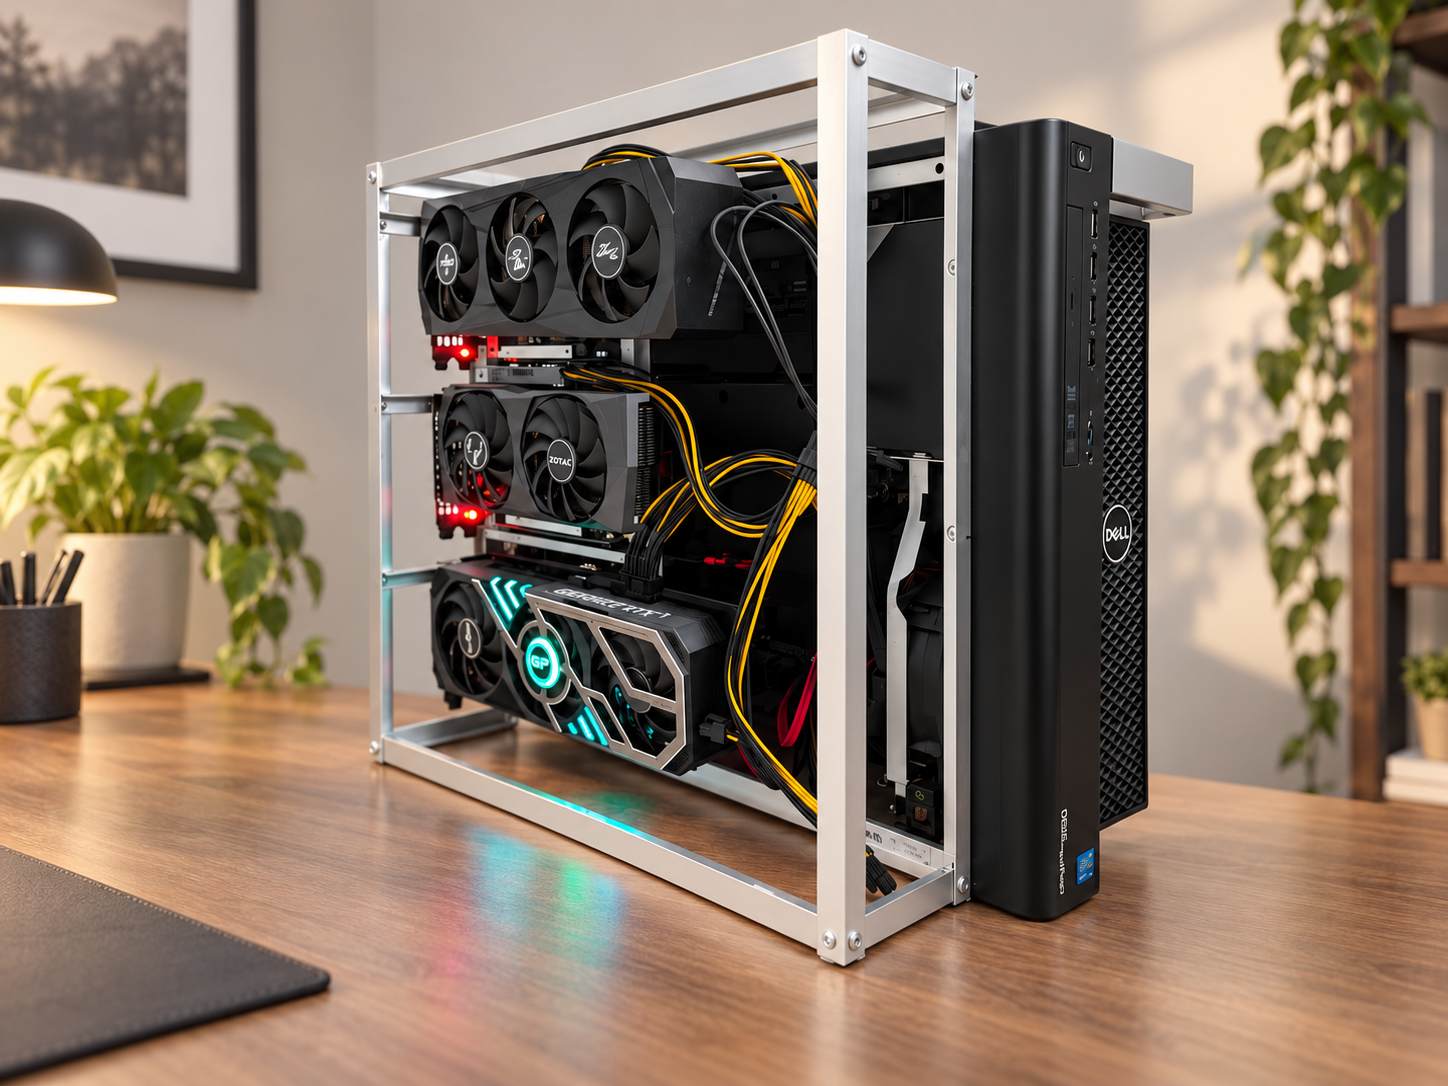
Tehisarutehnoloogiate õppimiseks ja praktiliseks proovimiseks otsustasime ehitada serveritööjaamast oma katselabori. Projekti eesmärk ei olnud luua ärilist serverit, vaid saada praktiline kogemus — Linuxi ja konteineritaristu seadistamisest kuni kohalike keelemudelite käivitamise, tehisaruagentide arendamise ja protsesside automatiseerimiseni.
Serverist sai õppekeskkond, kus saime katsetada erinevaid tehnoloogiaid, kontrollida hüpoteese, teha vigu ja leida lahendusi.
Mis serveris sees on
Aluseks on Dell Precision T7600 tööjaam.
- 2 × Intel Xeon E5-2680 protsessorit sagedusega 2,70 GHz
- 128 GB muutmälu
- 2 × NVIDIA RTX 3060 12 GB
- NVIDIA RTX 3080 Ti 12 GB
- Ubuntu Server 24.04 LTS
- kaks NVMe-ketast RAID 1 massiivis
Kokku on serveris 36 GB videomälu, kuid kolm videokaarti ei moodusta automaatselt üht 36 GB mäluga GPU-d. Nende koos kasutamiseks peavad tarkvara ja mudelid toetama arvutuskoormuse jaotamist GPU-de vahel. Sellise konfiguratsiooniga töötamine aitas meil paremini mõista tänapäevaste keelemudelite riistvaranõudeid ja kohaliku tehisaru piiranguid.
Mis serveris töötab
Peaaegu kõik töötab Dockeri konteinerites. Peamised tööriistad on:
- Ollama — kohalike keelemudelite käivitamiseks.
- Open WebUI — tuttav vestlusliides, kus on mugav erinevaid mudeleid katsetada ja võrrelda.
- OpenHands ja Hermes Agent — katseteks tehisaruagentidega, mis oskavad lisaks vastamisele ka tööriistu kasutada.
- n8n — protsesside automatiseerimiseks ning tehisaru ühendamiseks teiste teenustega.
- Dify — tehisarurakenduste ja andmetöötlusahelate katsetamiseks.
- ComfyUI — generatiivse graafikaga töötamiseks.
Süsteemi haldamiseks ja jälgimiseks kasutasime ka Portainerit ja Cockpiti.
Omaette osa praktikast oli töö Dockeriga: konteinerite seadistamine, ressursside haldamine, teenuste ühendamine ja vigade põhjuste otsimine.
Katsed keelemudelitega
Serveris käitasime eri suuruse ja otstarbega mudeleid, sealhulgas Qwen, DeepSeek, Gemma, Phi, Nemotron ja teised. Eraldi pakkusid huvi nn piiranguteta tehisaru mudelid (abliterated LLM-id) — neurovõrgud, milles on kunstlikke eetikafiltreid eemaldatud või välja lülitatud ning mis vastavad päringutele moraliseerimata ja vähemate piirangutega.
Näiteks:
- Qwen 3.6 35B A3B
- DeepSeek R1 32B
- Gemma 3 27B
- Qwen3-Coder 30B
- Phi-4 14B
- orcarouter/Qwen3.8-27B-Uncensored
Mudelite võrdlemisel ei vaadanud me ainult vastuste kvaliteeti, vaid ka praktilisi omadusi:
- tekstiloome kiirus;
- põhi- ja videomälu kasutus;
- võimalus jaotada koormust GPU-de vahel;
- programmeerimis- ja analüüsiülesannete täitmise kvaliteet;
- juhiste järgimine ja struktureeritud andmetega töötamine;
- riistvaranõuete ja saadud tulemuse suhe.
Kõige suurem mudel ei ole alati kõige sobivam. Konkreetse ülesande jaoks võib väiksem spetsialiseeritud mudel olla praktilisem ja ressursisäästlikum.
Tehisaru koos tööriistadega
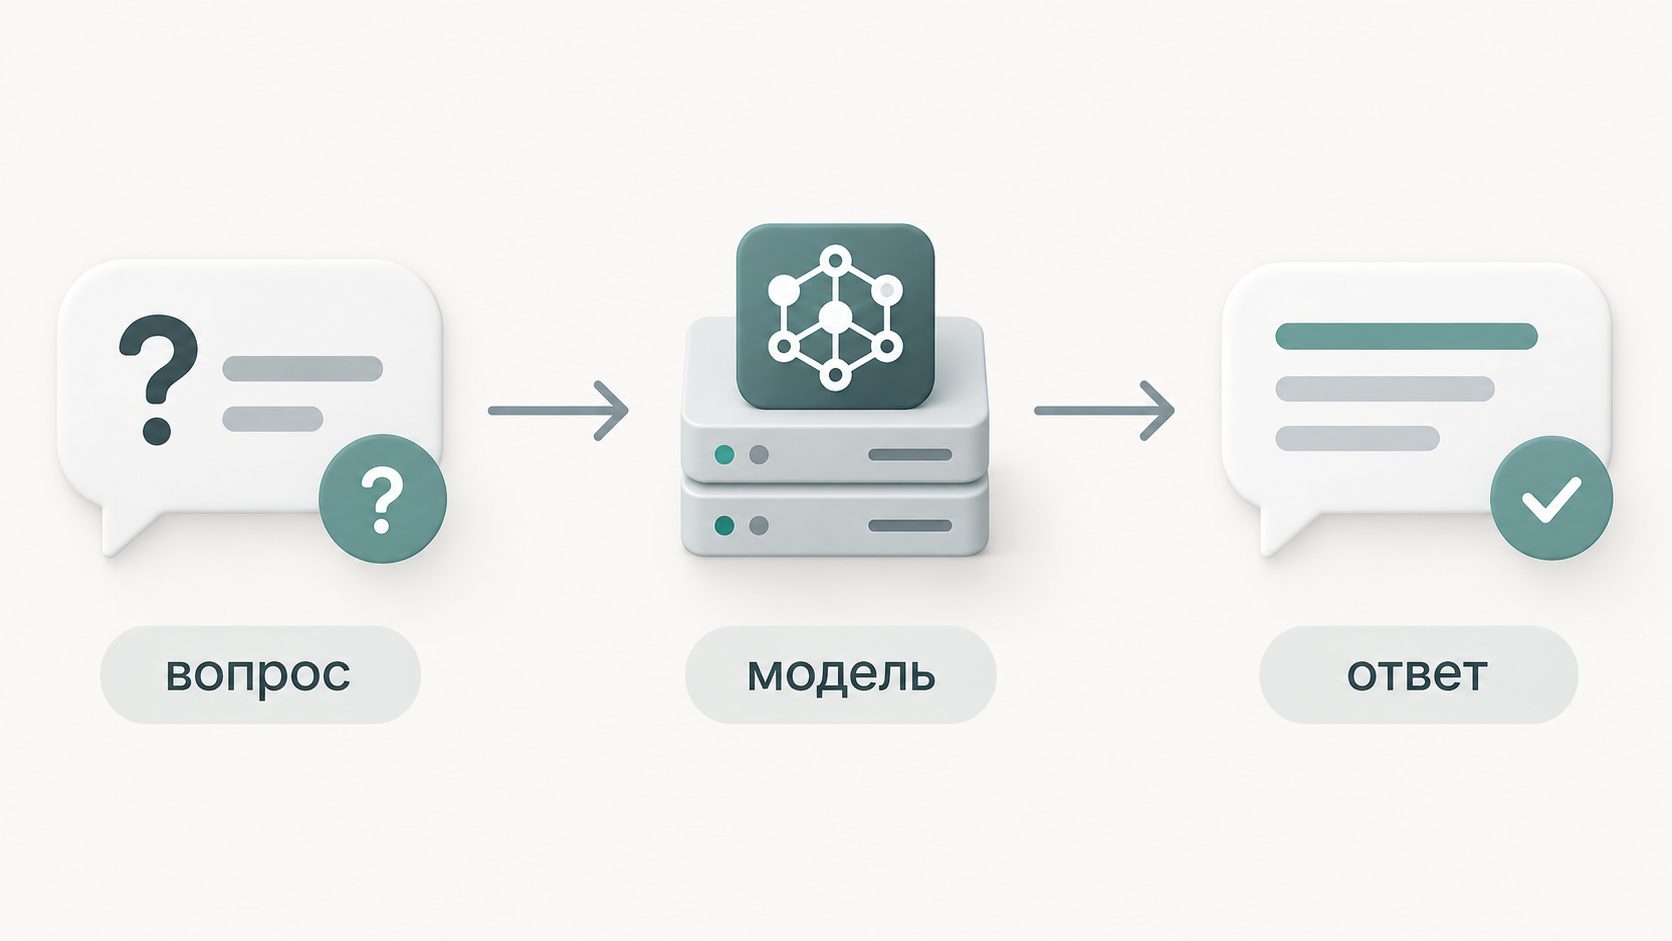
Tavaline vestlus töötab ligikaudu nii: küsimus → mudel → vastus.
Palju huvitavamad on süsteemid, kus mudel saab kasutada tööriistu: ülesanne → mudel → tegevus → tulemus → järgmine tegevus.
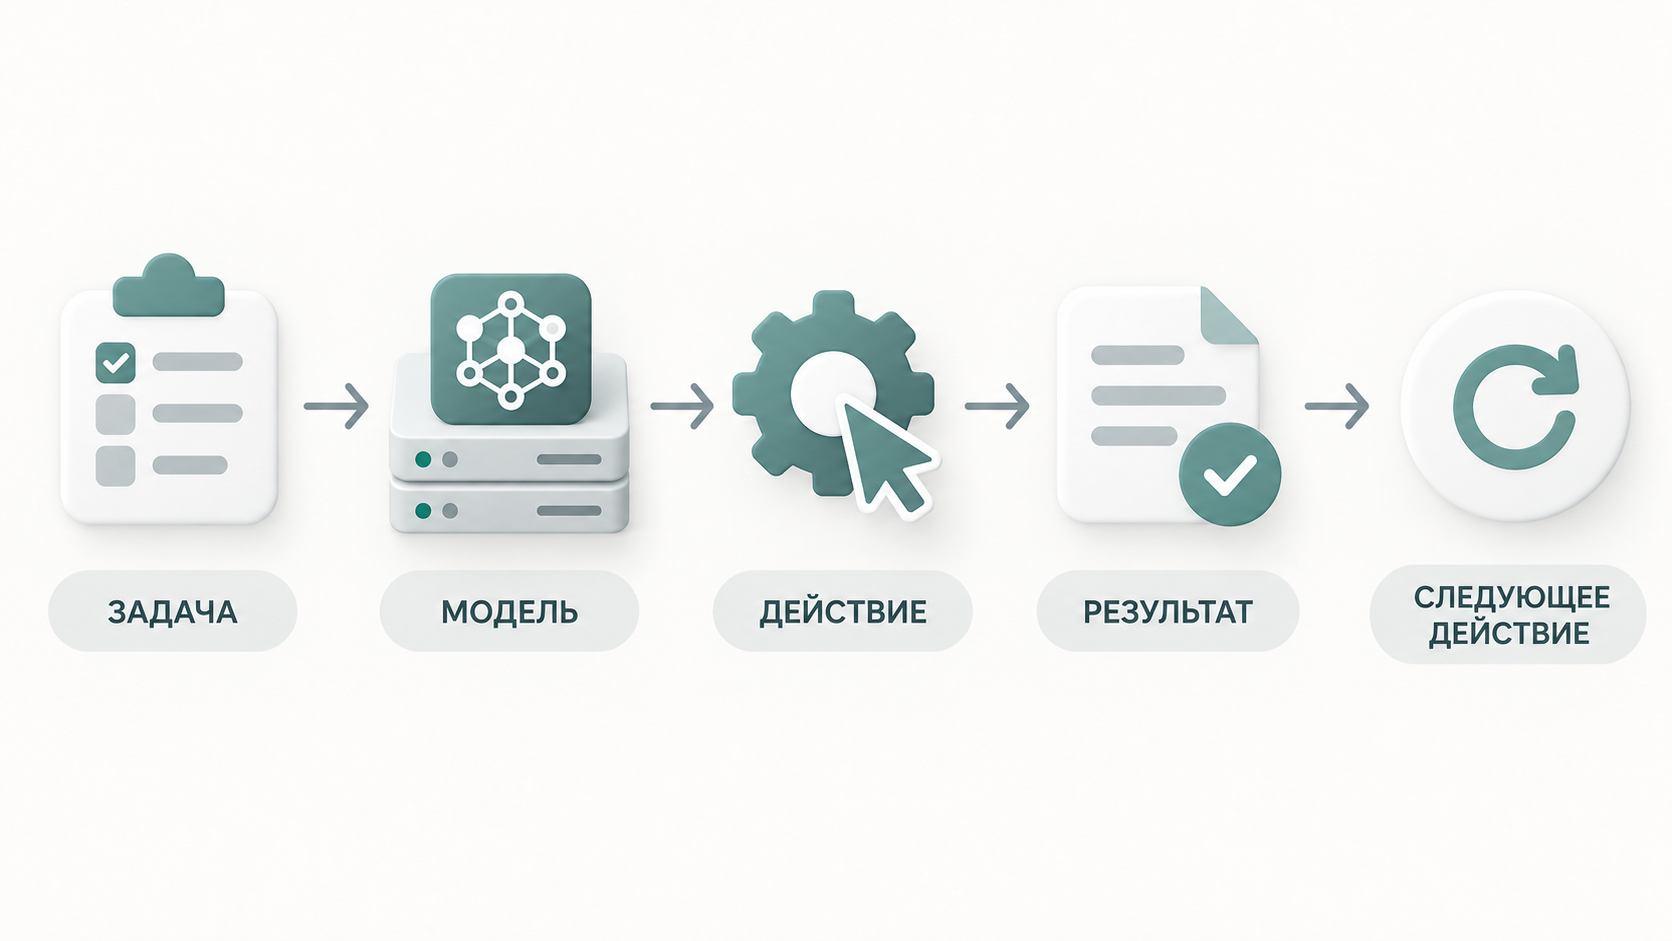
Agent võib näiteks lugeda faili, kutsuda välja API või käivitada lubatud käsu teises arvutis. Üks näide on Linuxi serveris töötav tehisaruagent, mis suhtleb SSH kaudu Windowsi arvutiga. Sellisel juhul pole tehisaru enam lihtsalt vestlusabiline, vaid toimiva süsteemi osa.
Milliseid ülesandeid uurisime
Õppeserveri ehitamine ei olnud eesmärk omaette. Tahtsime mõista, kuidas õpitut kasutada tarkvaraarenduses, automatiseerimises ja ettevõtete praktiliste ülesannete lahendamisel.
Selleks vaatasime mitut praktilist stsenaariumi.
1. Sotsiaalmeedia sisu ettevalmistamise automatiseerimine
Üks õppestsenaarium oli sotsiaalmeediapostituste ettevalmistamise automatiseeritud töövoog. Süsteem saab teema või lähtematerjali, koostab mitu tekstivarianti, kohandab sisu eri platvormidele ja valmistab ette pildi kirjelduse. Viimases etapis saadetakse materjal inimesele, kes kontrollib selle enne avaldamist üle.
See stsenaarium aitas uurida n8n-i, keelemudelite ja väliste teenuste koostööd. Samuti näitas see, milliseid tegevusi saab automatiseerida ja kus peab säilima inimese kontroll.
2. Mitme tarnija toodete otsimine ja võrdlemine
Teine uurimissuund oli eri B2B-kataloogide toodete sobitamine. Praktikas võib sama toode olla tarnijate juures erineva nime, tootekoodi ja kirjelduse vorminguga. Vaatasime, kuidas ehitada süsteem, mis kogub teavet mitmest allikast, sobitab tooted ning võrdleb hindu, saadavust, minimaalset tellimiskogust ja tarnetingimusi.
Eriti huvitas meid tehisaru kasutamine andmete ühtlustamiseks ja selliste vastete leidmiseks, mida on tavalise tekstivõrdlusega raske tuvastada.
3. Teabe eraldamine dokumentidest
Veel üks praktiline katse oli dokumentide automaatne analüüs. Uurisime, kuidas keelemudelid eraldavad struktureeritud teavet kirjadest, lepingutest, litsentsidest ja muudest dokumentidest. Eriti huvitas meid, kui usaldusväärselt suudab mudel leida kuupäevi, tähtaegu, kohustusi ja muid olulisi andmeid. Vaatasime ka võimalust ühendada leitud teave kalendrite ja meeldetuletussüsteemidega.
See suund aitab hästi mõista tehisaru piiranguid: eraldatud teave tuleb üle kontrollida, sest mudeli vigadel võivad olla tegelikud tagajärjed.
4. Kohalik tehisaru tarkvara osana
Õppimise käigus ühendasime keelemudeleid teiste rakendustega API kaudu. Põhimõte on üsna lihtne: programm saadab kohalikule mudelile päringu ja saab vastuse, mida kasutab seejärel oma tööprotsessis. Tehniliselt sarnaneb see pilvepõhiste tehisaruteenuste kasutamisega, kuid andmetöötlus toimub oma seadmes.
Uurisime, kuidas sellist suhtlust korraldada ning milliseid nõudeid seab see jõudlusele, vigade käsitlemisele ja rakenduse arhitektuurile.
Kohalik või pilvepõhine tehisaru?
Üks peamisi küsimusi, millele õppimise käigus vastust otsisime, oli see: millal on mõistlik käitada tehisaru kohapeal ja millal eelistada pilveteenust? ChatGPT, Claude ja kommerts-API-d pakuvad võimsaid mudeleid ning vabastavad kasutaja vajadusest arvutustaristut ise hooldada. Kohalik tehisaru annab omakorda rohkem kontrolli keskkonna, seadete ja andmetöötluse üle.
Katsete käigus hindasime erinevaid tegureid:
- kas kohaliku mudeli võimekusest piisab konkreetse ülesande jaoks;
- kui palju arvutusressurssi on vaja;
- kui olulised on vastuse kiirus ja stabiilsus;
- milliseid andmeid võib välisele teenusele edastada;
- kuidas kaitsta konfidentsiaalset teavet;
- millal on põhjendatud kohalike ja pilvepõhiste mudelite koos kasutamine.
Selgus, et universaalset lahendust ei ole. Mõne ülesande jaoks piisab väikestest kohalikest mudelitest. Teiste puhul on suure pilvesüsteemi võimalused sobivamad. Mõnikord on kõige mõistlikum kasutada hübriidarhitektuuri.
Tehisarulabor
Labori peamine väärtus ei olnud videokaartide või paigaldatud mudelite arv. Projekt võimaldas praktikas ühendada mitu teadmiste valdkonda: Linux, Docker, serverihaldus, võrgutehnoloogiad, infoturve, keelemudelid, programmeerimine ja automatiseerimine. Saime ise läbida kogu tee riistvara seadistamisest kuni tehisarurakenduste ja -agentidega katsetamiseni.
Kõik katsed ei andnud oodatud tulemust. Mõni mudel nõudis liiga palju ressursse, teine töötas aeglaselt või ebapiisava kvaliteediga ning osa tööriistu tuli ümber seadistada või välja vahetada. Ka see oli õppimise osa.