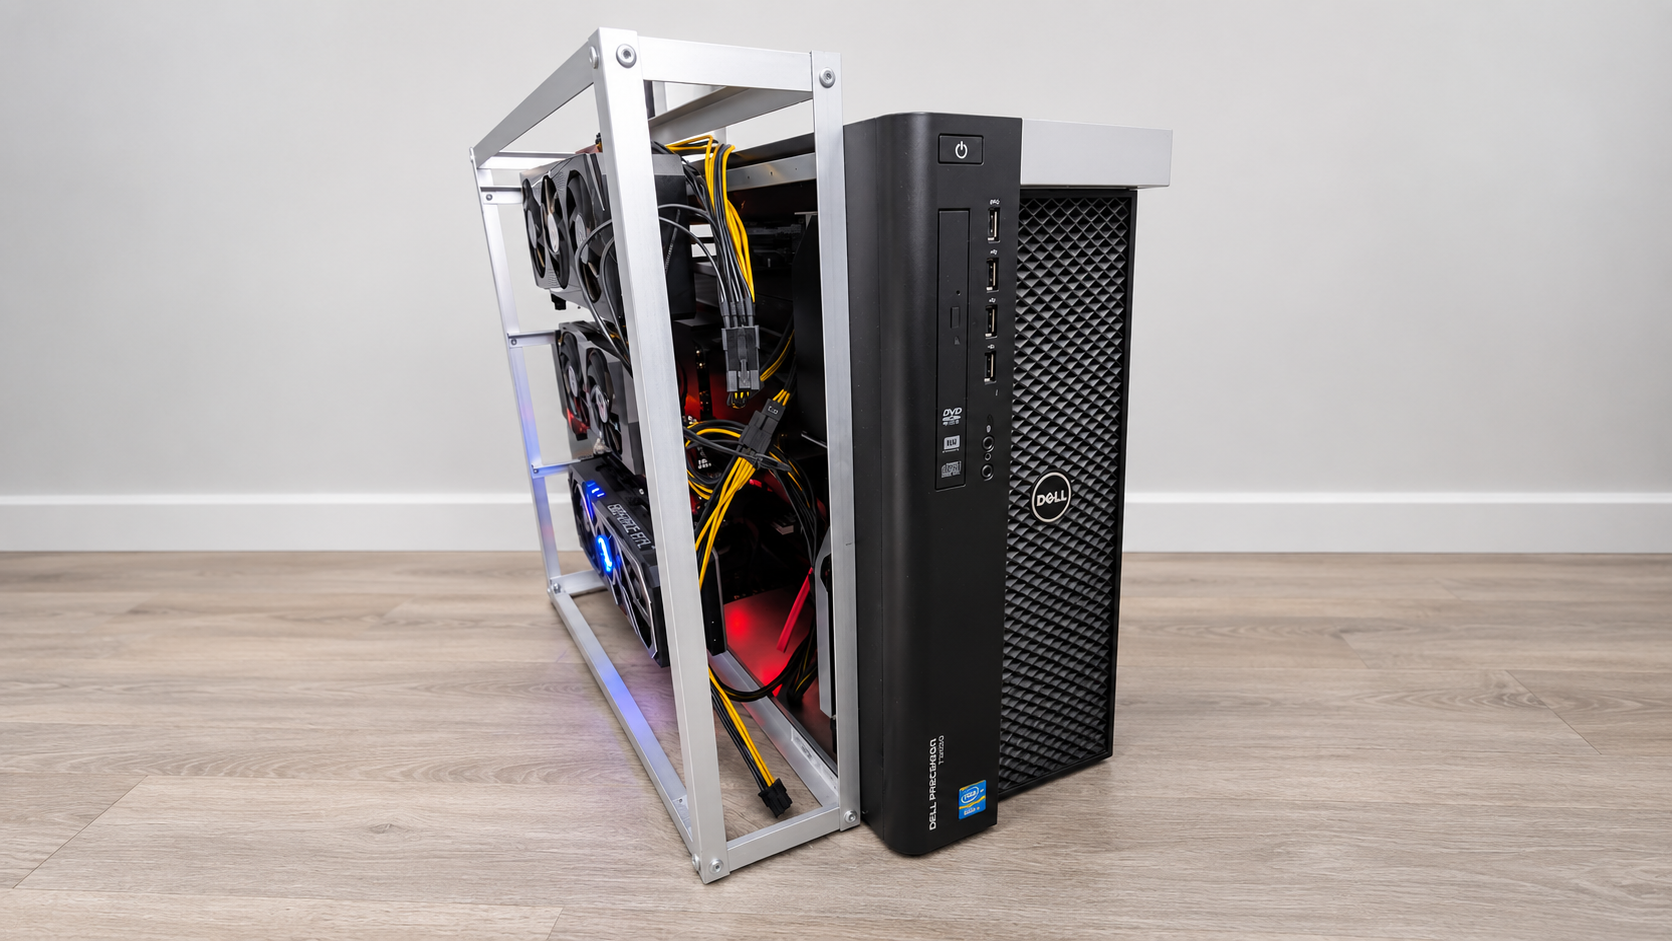
В рамках нашего обучения и практического освоения ИИ-технологий мы решили создать собственную экспериментальную лабораторию на базе серверной рабочей станции. Цель проекта заключалась не в создании коммерческого сервера, а в получении практического опыта: от настройки Linux и контейнерной инфраструктуры до запуска локальных языковых моделей, разработки ИИ-агентов и автоматизации процессов.
Этот сервер стал нашим учебным стендом, на котором мы могли экспериментировать с различными технологиями, проверять гипотезы, допускать ошибки и находить решения.
Что внутри
Основа — Dell Precision T7600 Workstation.
- 2 × Intel Xeon CPU E5-2680, 2,70 ГГц
- 128 ГБ оперативной памяти
- 2 × NVIDIA RTX 3060 12 ГБ
- NVIDIA RTX 3080 Ti 12 ГБ
- Ubuntu Server 24.04 LTS
- два NVMe-накопителя в RAID 1
Суммарно установлено 36 ГБ видеопамяти, но три видеокарты не превращаются автоматически в одну на 36 ГБ. Чтобы использовать их вместе, модель и программа запуска должны уметь распределять нагрузку между GPU. Работа с такой конфигурацией позволила лучше понять аппаратные требования современных языковых моделей и ограничения локального ИИ.
Что работает на сервере
Практически всё запускается в Docker-контейнерах. Основные инструменты:
- Ollama — для запуска локальных языковых моделей.
- Open WebUI — привычный интерфейс чата, через который удобно тестировать и сравнивать разные модели.
- OpenHands и Hermes Agent — для экспериментов с ИИ-агентами, которые могут не только отвечать на вопросы, но и использовать инструменты.
- n8n — для автоматизации и связывания ИИ с другими сервисами.
- Dify — для экспериментов с ИИ-приложениями и цепочками обработки данных.
- ComfyUI — для работы с генеративной графикой.
Для администрирования и наблюдения за системой мы также использовали Portainer и Cockpit.
Отдельной частью практики стала работа с Docker: настройка контейнеров, управление ресурсами, подключение сервисов друг к другу и поиск причин возникающих ошибок.
Эксперименты с языковыми моделями
На сервере запускались модели разных размеров и назначения: Qwen, DeepSeek, Gemma, Phi, Nemotron и другие. Особый интерес вызывают так называемые нецензурированные ИИ-модели (abliterated LLM) — нейросети с удалёнными или отключенными искусственными этическими фильтрами, которые отвечают на любые запросы без морализаторства и ограничений.
Например:
- Qwen 3.6 35B A3B
- DeepSeek R1 32B
- Gemma 3 27B
- Qwen3-Coder 30B
- Phi-4 14B
- orcarouter/Qwen3.8-27B-Uncensored
При сравнении моделей нас интересовало не только качество ответов, но и практические характеристики:
- Скорость генерации текста
- Использование оперативной и видеопамяти
- Возможность распределения нагрузки между GPU
- Качество выполнения задач программирования и анализа
- Работа с инструкциями и структурированными данными
- Соотношение требований к оборудованию и получаемого результата
Самая большая модель далеко не всегда является наиболее подходящей. Для конкретной задачи небольшая специализированная модель иногда оказывается практичнее и экономичнее.
ИИ с инструментами
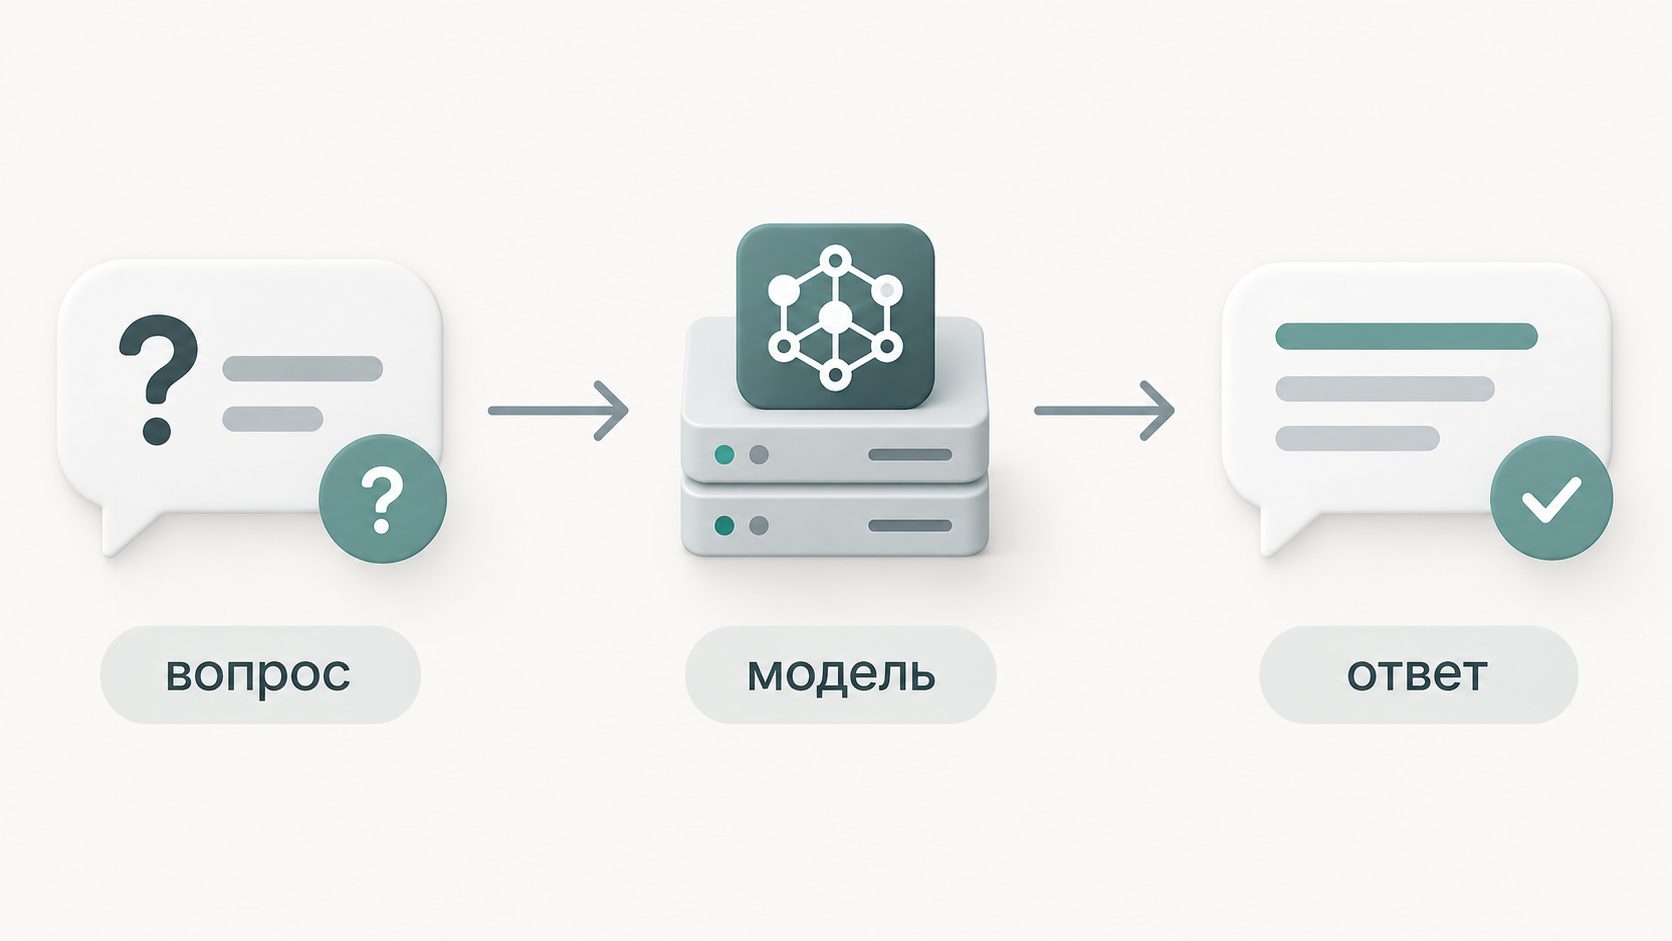
Обычный чат работает примерно так: вопрос → модель → ответ.
Но намного интереснее системы, где модель может пользоваться инструментами: задача → модель → действие → результат → следующее действие.
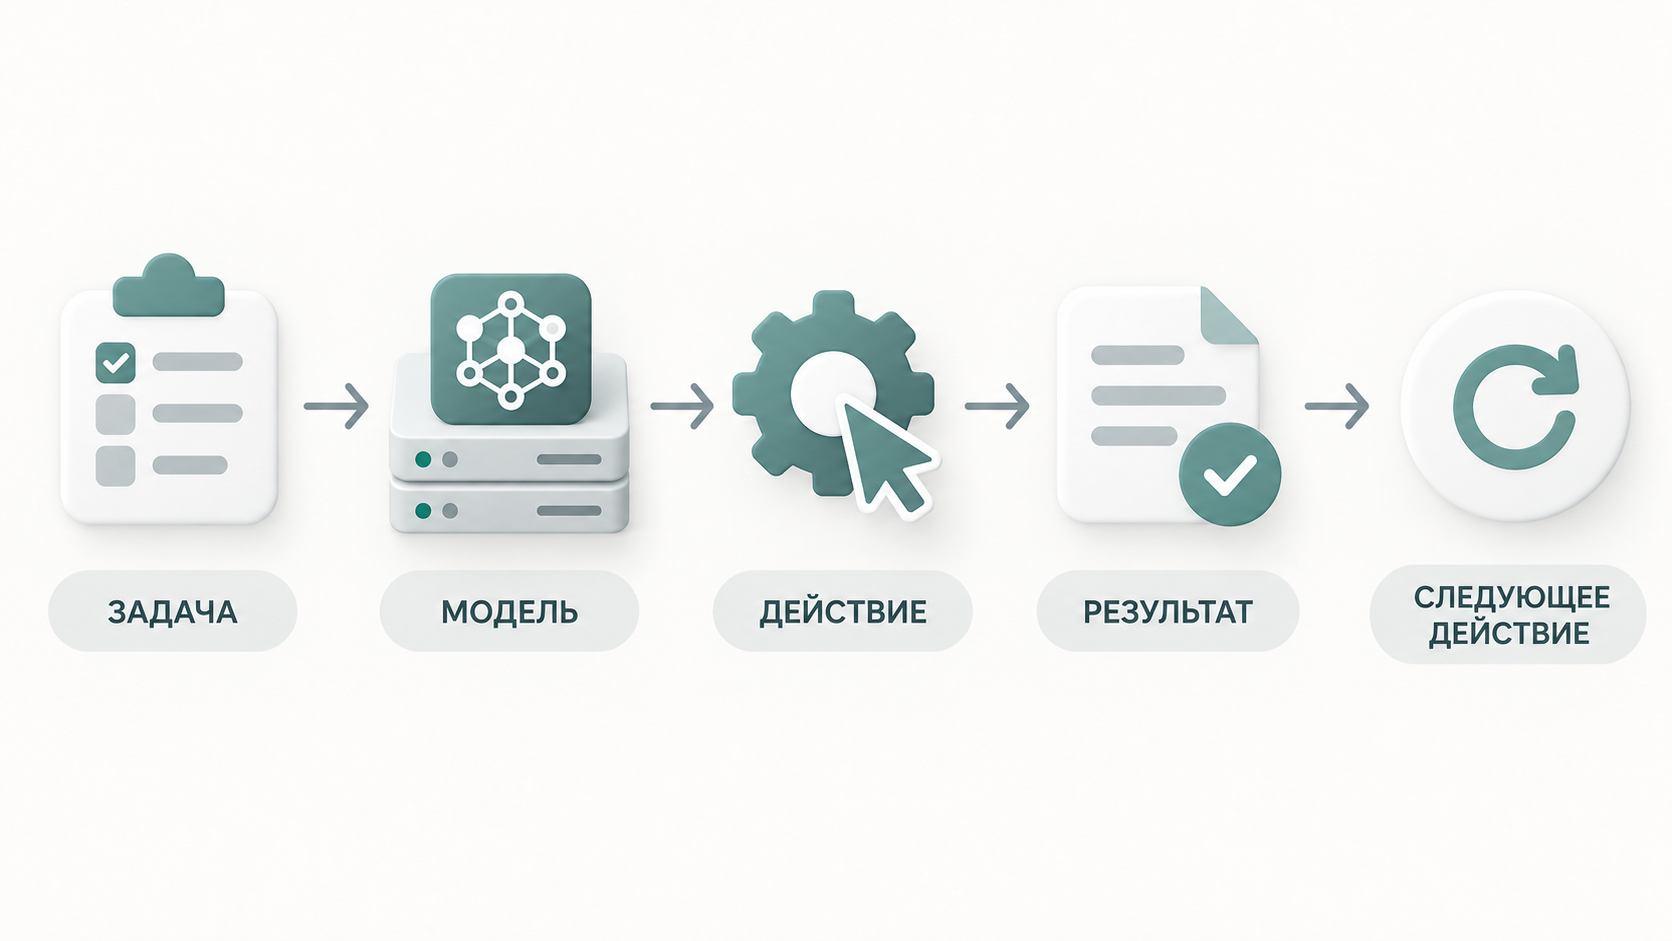
Например, агент может прочитать файл, вызвать API или выполнить разрешённую команду на другой машине. Например, ИИ-агент, работающий на Linux-сервере и взаимодействующий с Windows-компьютером через SSH. В этот момент ИИ уже перестаёт быть просто чат-ботом и становится частью полноценной работающей системы.
Какие задачи мы изучали
Создание учебного сервера было не самоцелью. Нам было важно понять, как полученные знания можно применить в разработке программ, автоматизации и решении задач бизнеса.
Для этого мы рассматривали несколько практических сценариев.
1. Автоматизация подготовки контента для социальных сетей
Один из учебных сценариев — автоматизированная цепочка подготовки публикаций. Система получает тему или исходный материал, формирует несколько вариантов текста, адаптирует содержание под разные площадки и подготавливает описание изображения. На заключительном этапе материалы передаются человеку на проверку перед публикацией.
Такой сценарий позволял изучать взаимодействие n8n, языковых моделей и внешних сервисов, а также определять, какие операции можно автоматизировать и где необходимо сохранить человеческий контроль.
2. Поиск и сравнение товаров нескольких поставщиков
Другим направлением стало изучение задачи сопоставления товаров из разных B2B-каталогов. На практике одинаковый товар у нескольких поставщиков может иметь разные названия, артикулы и форматы описания. Мы рассматривали, как можно построить систему, которая собирает информацию из разных источников, сопоставляет товары и сравнивает цены, наличие, минимальную партию и условия поставки.
Особый интерес представляло использование ИИ для нормализации данных и поиска совпадений, которые трудно обнаружить обычным текстовым сравнением.
3. Извлечение информации из документов
Ещё одно направление практических экспериментов — автоматический анализ документов. Задача заключалась в изучении возможностей языковых моделей по извлечению структурированной информации из писем, договоров, лицензий и других документов. В частности, нас интересовало, насколько надёжно модель может находить даты, сроки, обязательства и другие значимые сведения. Также рассматривалась возможность дальнейшей интеграции таких данных с календарями и системами напоминаний.
Это направление особенно полезно для понимания ограничений ИИ: извлечённую информацию необходимо проверять, а ошибки модели могут иметь реальные последствия.
4. Локальный ИИ как часть программного обеспечения
Отдельной частью обучения стала интеграция языковых моделей с другими приложениями через API. Принцип здесь достаточно простой: программа отправляет запрос локальной модели и получает ответ, который затем использует в собственном рабочем процессе. С технической точки зрения это напоминает взаимодействие с облачными ИИ-сервисами, но обработка выполняется на собственном оборудовании.
Мы изучали, как организовать такое взаимодействие и какие требования оно предъявляет к производительности, обработке ошибок и архитектуре приложений.
Локальный или облачный ИИ?
Один из главных вопросов, на который мы искали ответ в ходе обучения: когда действительно имеет смысл запускать ИИ локально, а когда лучше использовать облачный сервис? Такие решения, как ChatGPT, Claude и коммерческие API, предлагают мощные модели и избавляют от необходимости самостоятельно обслуживать вычислительную инфраструктуру. Локальный ИИ, в свою очередь, предоставляет больше контроля над окружением, настройками и обработкой данных.
В процессе экспериментов мы оценивали разные факторы:
- Достаточно ли возможностей локальной модели для конкретной задачи?
- Какой объём вычислительных ресурсов необходим?
- Насколько важны скорость и стабильность ответа?
- Какие данные можно передавать внешнему сервису?
- Как обеспечить безопасность при работе с конфиденциальной информацией?
- Когда оправдано сочетание локальных и облачных моделей?
В результате стало понятно, что универсального решения не существует. Для одних задач достаточно небольших локальных моделей. Для других предпочтительнее возможности крупных облачных систем. А в некоторых случаях наиболее разумной оказывается гибридная архитектура.
ИИ-лаборатория
Главная ценность созданной лаборатории заключалась не в количестве видеокарт или установленных моделей. Этот проект позволил на практике соединить несколько направлений знаний: Linux, Docker, серверное администрирование, сетевые технологии, информационную безопасность, языковые модели, программирование и автоматизацию. Мы получили возможность самостоятельно пройти путь от настройки оборудования до экспериментов с ИИ-приложениями и агентами.
Не все эксперименты давали ожидаемый результат. Одни модели требовали слишком много ресурсов, другие работали медленно или недостаточно качественно, а некоторые инструменты приходилось перенастраивать или заменять. Но именно это и было частью обучения.