
Важные решения, просто полезные заметки, выводы, наблюдения и рабочие моменты быстро расползаются по заметкам, чатам и документам. Через несколько месяцев нужную деталь уже приходится искать очень долго. Да, мы пользуемся Notion, но для коротких мыслей он кажется нам слишком громоздким, поэтому не всё храним там.
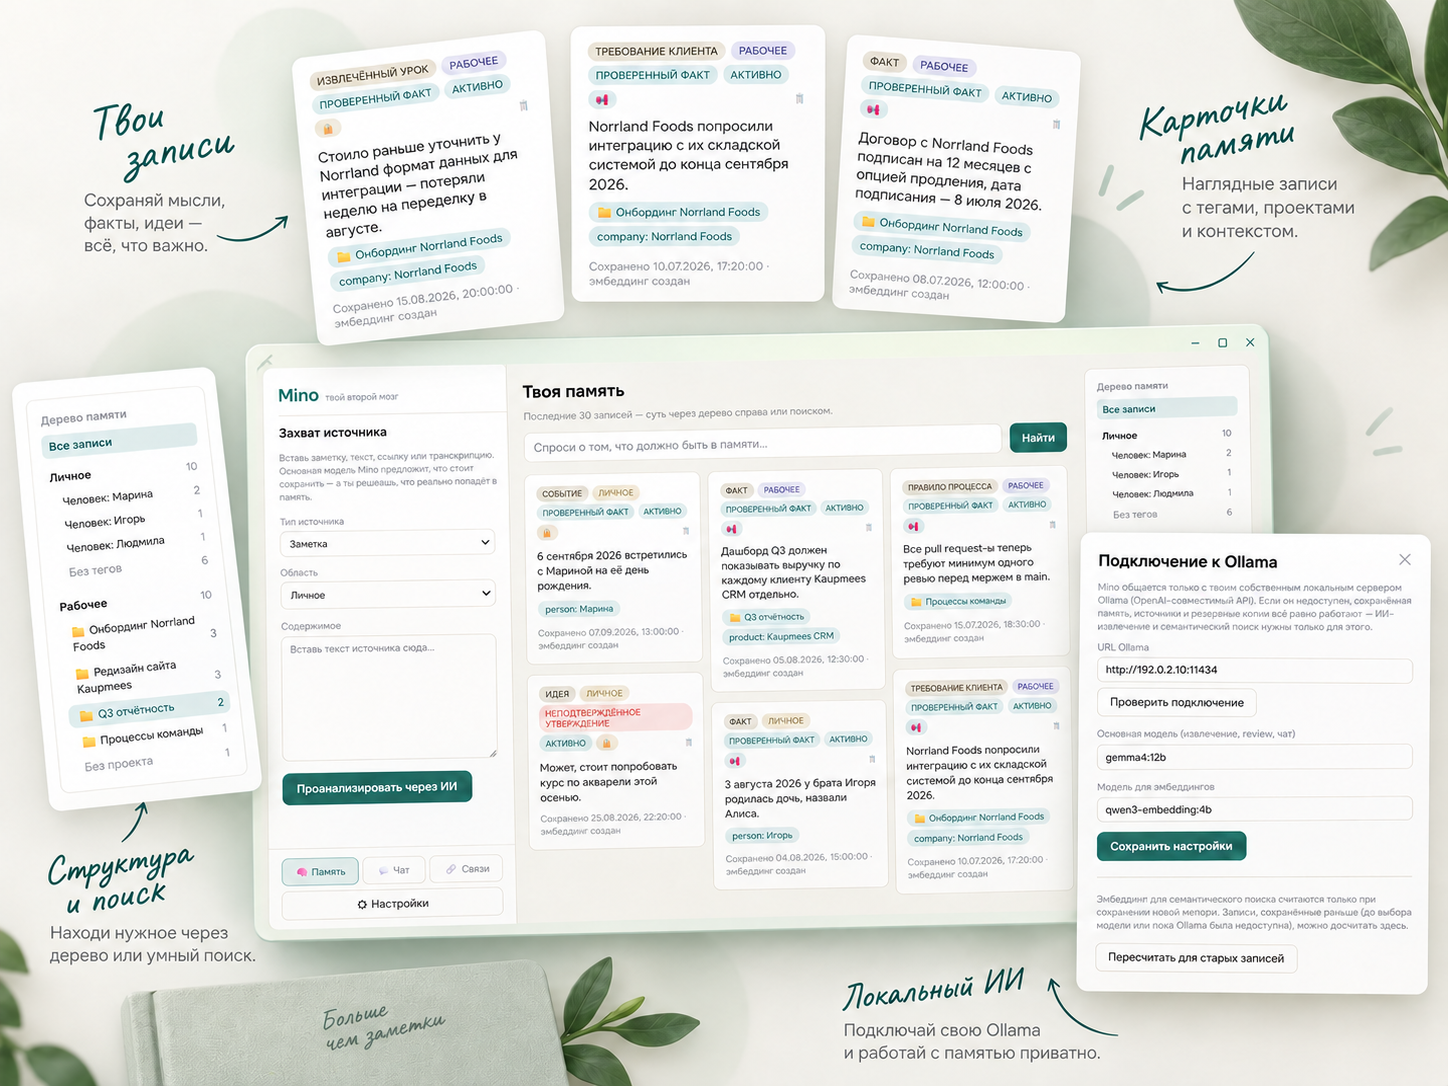
Mino — Windows-приложение, которое мы создаём как второй мозг. Одна память, разделённая на личное и рабочее.
Работает просто
Добавляем текст, ссылку, заметку или расшифровку — локальная модель предлагает, что из этого стоит сохранить как отдельное воспоминание: факт, событие, решение, вывод, идею, правило или другую важную информацию. Каждую запись мы проверяем. Mino ничего не сохраняет автоматически и не перезаписывает старые данные молча. Если информация изменилась, предыдущая версия остаётся в истории, а новая связывается с ней.
Для нас принципиально, чтобы эта память оставалась нашей. База хранится локально рядом с приложением, а ИИ работает через наш Ollama-сервер (наша локальная ИИ-лаборатория). Данные не нужно отправлять во внешний облачный сервис, а саму папку Mino вместе с памятью можно легко переносить.
Разговор с "памятью"
Нормальный поиск и чат с собственной памятью: не только искать по словам, но и задавать вопросы вроде:
Что происходило с этим проектом? Почему я тогда приняла такое решение? Что я уже выяснила по этой теме?
Как Mino понимает смысл записей
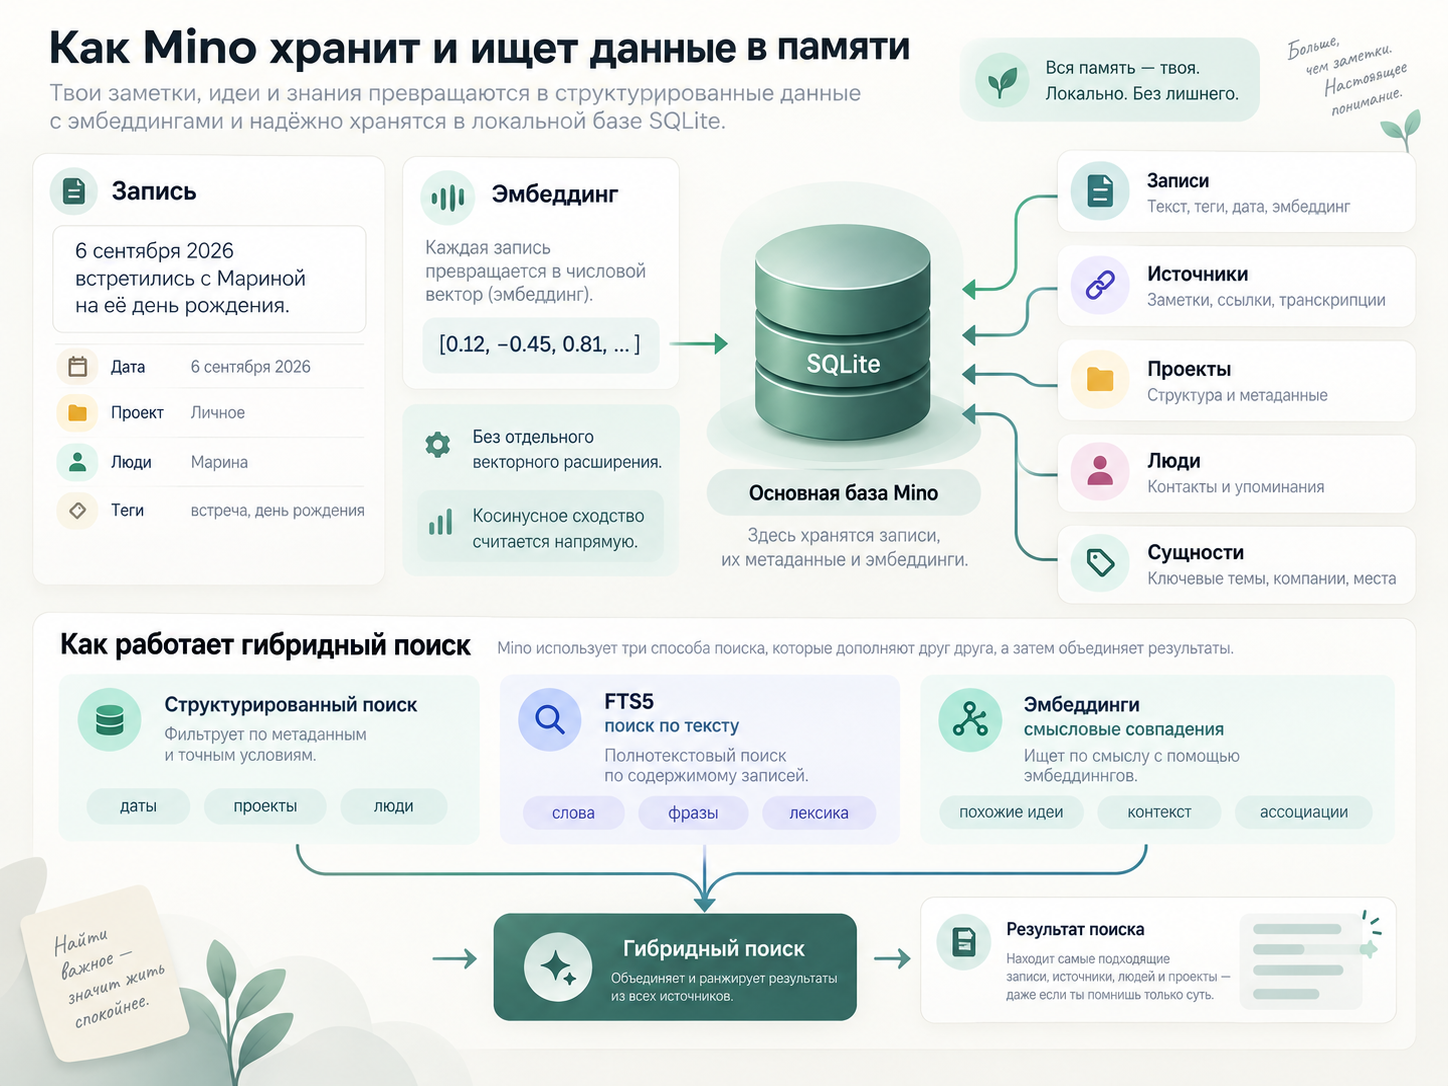
Для каждой сохранённой записи Mino создаёт эмбеддинг (числовое представление смысла текста). Какую модель для этого использовать, мы выбираем в настройках, через локальный Ollama, сейчас мы используем Qwen3-Embedding 4B, но привязки к конкретной модели в самом Mino нет.
Проще говоря, текст превращается в набор чисел, по которому можно находить похожие записи даже тогда, когда в них используются совсем разные слова. Например, запрос про "решение по клиенту" сможет найти запись, где написано "договорились изменить формат интеграции", даже если точной фразы из запроса там нет.
Основная база Mino — SQLite. В ней хранятся сами записи, источники, проекты, люди и другие сущности, а эмбеддинг каждой записи сохраняется рядом в виде числового вектора. Отдельное расширение для векторного поиска мы не подключали: при объёме личной базы знаний (не миллионы записей) косинусное сходство можно посчитать напрямую, без нативных зависимостей, а значит и без риска, что приложение однажды перестанет собираться на другой системе. Поиск при этом гибридный: точные данные — даты, проекты, люди — ищутся как обычные структурированные данные, текст — через FTS5, а смысловые совпадения — через эмбеддинги.
Связи
Для самих записей Mino умеет находить смысловое сходство — предлагает "эта запись, кажется, связана с той", основываясь на эмбеддингах. Для проектов и людей логика другая: Mino следит за дублями по написанию и если два имени похожи из-за опечатки или разного регистра ("Toca Boca Style Game" и "Toca boca game"), предлагает объединить их в одно. В обоих случаях это только предложение, ничего не объединяется и не связывается автоматически.
Mino это не ещё одно место для заметок. Это попытка собрать личную и рабочую память в систему, к которой можно вернуться в любой момент и восстановить нужный контекст.